

Assistant documentaire privé
Posez des questions à vos documents depuis une interface de conversation, dans vos locaux : réponses avec références, accès par dossier ou par équipe.
Dès 16 Go de VRAMProduit neuf testé, livré en 7 jours ouvrés · Garantie constructeur · SAV en France
Stations IA prêtes à l'emploi dès 2 490 €, rigs multi-GPU et serveurs : du matériel neuf testé, configuré selon vos modèles et vos logiciels, livré ou hébergé.

Station IA Threadripper1 à 3 NVIDIA RTX PRO 6000 Blackwell 96 Go
dès 48 990 € HTRéservation avec 500 € d'acompte remboursable
Estimation indicative : 60 % d'occupation, électricité à 0,20 €/kWh et commission déduites. Revenus variables, non garantis.
Quatre configurations simples, montées et testées par nos soins avec des composants neufs : vous branchez la station, vous ouvrez l'interface de conversation dans votre navigateur et vous travaillez. Vos données restent chez vous.
1× NVIDIA RTX 5060 Ti 16 Go
Qwen3 8B / 14BGemma 3 12Bgpt-oss-20bQwen3-VL 8BFlux
Assistant documentaire privé, premiers projets IA, 1 à 3 utilisateurs.
1× NVIDIA RTX 5070 Ti 16 Go
Qwen3 8B / 14BGemma 3 12Bgpt-oss-20bMistral Small 24BFlux
Réponses et images nettement plus rapides, pour une petite équipe.
2× NVIDIA RTX 5060 Ti 16 Go
Qwen3 32BQwen3-VL 32BGemma 3 27BQwen3-30B-A3BDeepSeek-R1 32B
Modèles de 30 milliards de paramètres, vision et documents, deux modèles en parallèle.
2× NVIDIA RTX 5070 Ti 16 Go
Qwen3 32BQwen3-VL 32BGemma 3 27BQwen3-30B-A3BFlux
Plusieurs utilisateurs simultanés, assistants rapides, images et vidéo.
Pour les modèles de 70 milliards de paramètres et plus : Threadripper 24 cœurs, 1 à 3 NVIDIA RTX PRO 6000 Blackwell 96 Go, 128 ou 256 Go de RAM ECC. Sur devis, dès 21 990 € HT, réservation par acompte de 500 € remboursé si vous renoncez. Serveurs 8 GPU également sur devis.
Prix TTC, montage, installation (Linux, pilotes NVIDIA, Ollama, interface Open WebUI) et test en charge compris. Produit neuf testé et livré en 7 jours ouvrés. Installation dans vos locaux, hébergement chez nous ou connexion à vos documents : sur devis.
Posez des questions à vos documents depuis une interface de conversation, dans vos locaux : réponses avec références, accès par dossier ou par équipe.
Dès 16 Go de VRAMFaites tourner Llama, Mistral, Qwen ou DeepSeek sur vos propres machines : vos données restent chez vous.
16 à 96 Go de VRAMGénération d'images et de vidéos (Stable Diffusion, Flux…), upscaling et montage accéléré.
16 à 32 Go de VRAMAdaptez un modèle à vos données métier avec LoRA ou un entraînement complet sur plusieurs GPU.
48 Go et plus, multi-GPURendu 3D, simulation, calcul scientifique : la puissance parallèle des GPU au service de vos projets.
Selon le logicielUne station de bureau dans un boîtier fermé, pour interroger votre documentation depuis une interface de conversation : documents, index et réponses restent chez vous. Station livrée prête à l'emploi, connexion à vos documents et installation sur devis.
Station Essentiel 16 Go dès 2 490 € TTC · connexion à vos documents sur devisServeurs 8 GPU NVIDIA (RTX PRO 6000 Blackwell, L40S, HGX B300) pour l'inférence et l'entraînement en entreprise. Configurés et livrés sur devis.
Voir tout (12)Rigs multi-GPU prêts à l'emploi et châssis ouverts pour monter votre propre station de calcul.


Cartes graphiques et PC équipés, à l'unité, pour compléter une station existante.
Voir tout (41)Alimentations serveur et ATX haute puissance, breakout boards et câbles pour alimenter plusieurs GPU en sécurité.


Cartes mères multi-PCIe pour rigs et stations de calcul, avec les processeurs et mémoires compatibles.


Processeurs et mémoire vive pour compléter une station : le reste des composants est dans la collection Mémoires.
Modèles à faire tourner, logiciels, budget, contraintes de place ou d'électricité : un appel suffit pour cadrer votre projet et vous proposer une configuration adaptée.
La VRAM décide de la taille du modèle que vous pouvez charger. Ordres de grandeur pour faire tourner un modèle de langage (poids seuls, hors contexte long).
Valeurs indicatives : prévoir 10 à 30 % de plus pour le contexte et le traitement par lots. L'entraînement demande nettement plus de mémoire.
Avant de choisir une machine, voyez ce qui se passe à l'intérieur : nos visites 3D et nos guides montrent comment un modèle de langage produit sa réponse, ce que fait un GPU pendant ce temps, combien il peut rapporter et comment bien s'équiper.
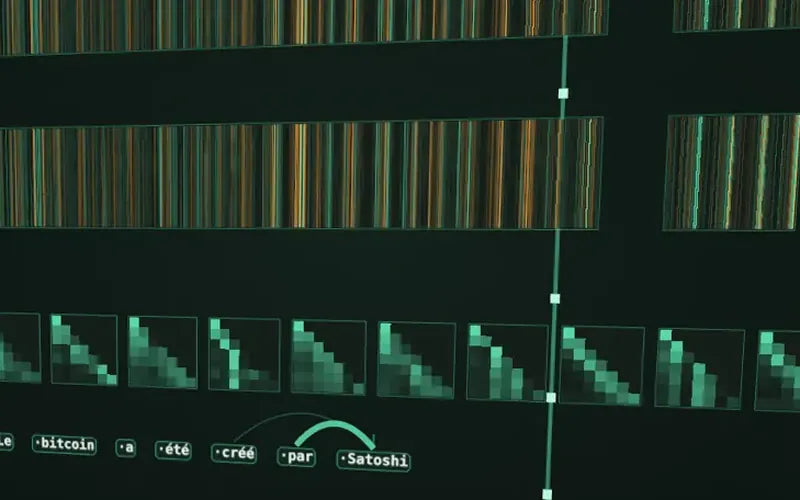 Visite 3D
Suivez une phrase dans un vrai modèle d'IA : découpage en tokens, attention, 24 étages et choix du mot suivant.
Lancer la visite 3D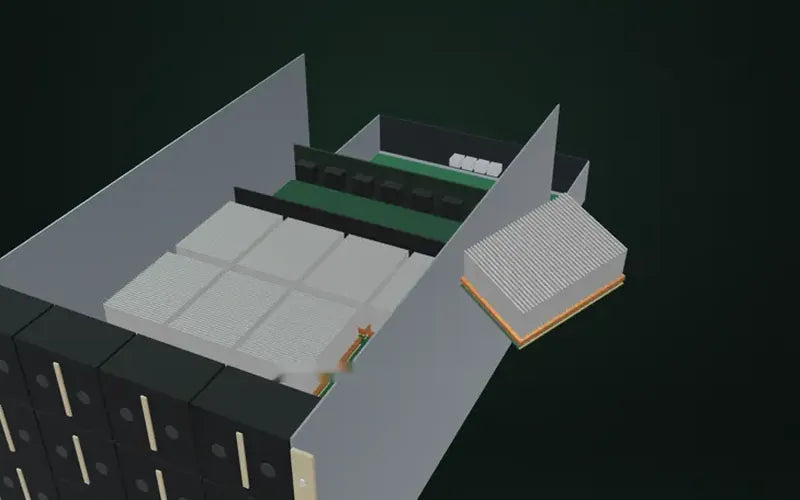 Vue éclatée 3D
Du serveur 8 GPU jusqu'au Tensor Core : la puce GH100, ses 141 Go de mémoire HBM3e et le trajet des données pendant un calcul d'IA.
Explorer le H200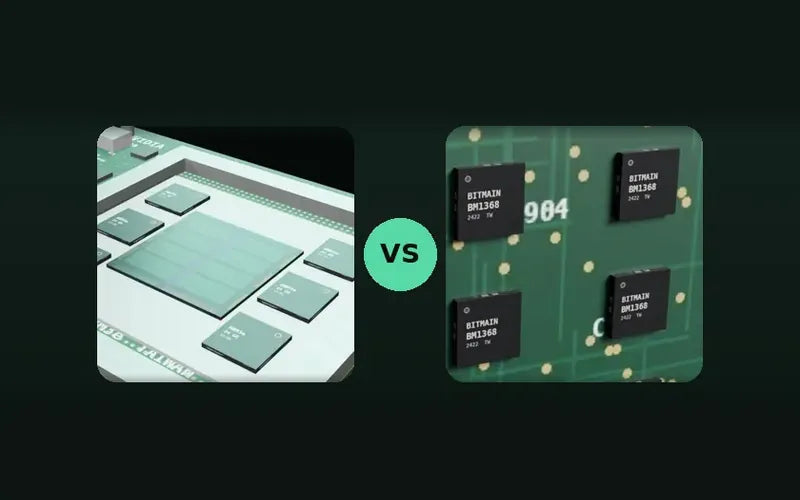 Guide
Pourquoi un GPU fait tourner n'importe quel modèle, pourquoi un Antminer ne le peut pas, et où se placent les TPU de Google.
Lire le comparatif Outil
Ce que rapporte un GPU loué pour l'IA, électricité déduite : revenu mensuel net et durée d'amortissement, modèle par modèle.
Calculer ma rentabilité Guide
Ce qu'une IA qui tourne dans vos murs change pour la confidentialité, ce qui ne change pas, et le matériel à prévoir.
Lire le guide Guide
Notre sélection mise à jour chaque mois : quel modèle ouvert faire tourner avec 16, 32, 96 Go ou un serveur.
Lire le guide Guide
Mémoire vidéo, carte graphique, processeur : comment choisir la machine selon les modèles que vous visez.
Lire le guide Guide
Cloud à l'heure, machine dans vos locaux ou hébergée en France : le calcul pour choisir la bonne option.
Lire le guide Guide
Comment une chaîne de blocs certifie une image, un jeu de données ou une décision d'IA, expliqué en 3D.
Lire le guideModèles, logiciels, volume de données, budget et contraintes d'installation (bruit, électricité, place).
Nous proposons les GPU, la mémoire, le stockage et l'alimentation adaptés, avec un devis détaillé.
La machine est assemblée, mise à jour et testée en charge avant l'expédition.
Livrée prête à l'emploi en France et en Europe, ou hébergée et maintenue dans nos locaux.
Une carte de 16 Go suffit pour les modèles jusqu'à 14 milliards de paramètres et pour un assistant documentaire. 32 Go, par exemple deux cartes de 16 Go, couvrent les modèles d'environ 30 milliards de paramètres quantifiés et la génération d'images. Les modèles de 70 milliards demandent 48 à 96 Go ou plusieurs GPU. Le guide VRAM ci-dessus donne les ordres de grandeur, et notre visite 3D d'un LLM montre ce que le modèle fait de cette mémoire.
Le GPU à l'unité complète une station existante. Le rig réunit plusieurs cartes dans une machine dimensionnée pour elles (alimentation, refroidissement). Le serveur IA 8 GPU vise l'entreprise : fiabilité, interconnexion rapide entre les cartes et fonctionnement en continu. Pour voir ce qu'il y a dans un tel serveur, explorez le GPU NVIDIA H200 en 3D.
Oui. Transmettez-nous vos logiciels, vos modèles, votre besoin en mémoire et vos contraintes d'installation : nous étudions une configuration adaptée et vous envoyons un devis.
Oui, comme pour nos mineurs : la machine peut être hébergée, alimentée et surveillée dans nos locaux, avec un accès à distance.
Deux RTX 5060 Ti ou RTX 5070 Ti de 16 Go offrent 32 Go de VRAM pour nettement moins cher qu'une RTX 5090, aujourd'hui rare et chère. Ollama, llama.cpp ou vLLM répartissent le modèle sur les deux cartes, et vous pouvez aussi faire tourner deux modèles en même temps, un par carte. Une seule carte de 32 Go reste plus rapide sur un gros modèle : nous la proposons sur devis selon les disponibilités.
Non. Un Antminer ne sait calculer que le SHA-256 du bitcoin : il n'a ni mémoire pour les poids d'un modèle, ni unités pour multiplier des matrices. L'IA demande des GPU, ou des ASIC conçus pour elle comme les TPU de Google, qui ne sont pas en vente libre. Notre comparatif ASIC ou GPU explique pourquoi, puce par puce.
Cela dépend du modèle de carte, du taux d'occupation et de votre prix de l'électricité. Notre calculateur de rentabilité GPU estime le revenu mensuel net et la durée d'amortissement, modèle par modèle. Ce sont des estimations indicatives, pas une garantie de revenus.
Donnez-nous vos modèles, vos logiciels et votre budget : nous vous proposons une configuration testée, livrée ou hébergée.
Merci de vous être abonné !
Cet email a été enregistré !


